Comunidade técnica lança benchmark cruzado que coloca ChatGPT 5.2 e Gemini lado a lado
Nova ferramenta independente mede factualidade, raciocínio e alinhamento multimodal de ambos os modelos e abre debate sobre interoperabilidade entre gigantes da IA
Uma iniciativa da comunidade técnica lançou esta semana uma suíte de avaliação pensada para comparar, de forma padronizada, ChatGPT na versão 5.2 e a família Gemini. O projeto nasce como uma tentativa de responder a duas necessidades crescentes no ecossistema de inteligência artificial: por um lado, a busca por avaliações comparáveis que ultrapassem benchmarks sintéticos e, por outro, a demanda de empresas e integradores por critérios objetivos na seleção e composição de modelos. A suíte, batizada pela equipe como CrossEval, reúne um conjunto de tarefas de linguagem e multimodalidade — incluindo verificações de factualidade em textos longos, cadeias de raciocínio com múltiplas etapas, testes de coerência em diálogo e estresse em inputs adversariais multimodais — e a aplica de maneira idêntica aos dois sistemas para reduzir variáveis externas.O anúncio destaca que o propósito do esforço não é proclamar um vencedor, mas mapear áreas nas quais cada arquitetura tende a falhar ou prosperar quando submetida ao mesmo conjunto de solicitações. A abordagem inclui também medições de latência e estabilidade sob carga, métricas cada vez mais relevantes para adoção em produção. Importante: o trabalho foi desenvolvido de forma aberta, com repositório de testes e scripts de execução acessíveis à comunidade técnica, permitindo reprodução dos resultados em ambientes controlados. Em poucas horas após a divulgação, consultores de empresas de tecnologia, integradores e grupos de pesquisa começaram a executar suas próprias variações dos testes, ampliando o debate sobre como comparar sistemas que evoluem rapidamente e apresentam conjuntos distintos de capacidades multimodais.
Do ponto de vista técnico, a suíte CrossEval foi desenhada em três camadas: a camada de orquestração, responsável por enviar prompts e inputs multimodais às APIs; a camada de execução, que padroniza tempo e formato das chamadas; e a camada de análise, que aplica métricas automáticas e avaliação humana quando necessário. A orquestração permite alternar entre endpoints e simular condições de produção, incluindo concorrência de requisições e variação de contexto por usuário. Já a execução uniformiza prompts por meio de templates que garantem equivalência semântica entre enunciados, evitando vieses de engenharia de prompt que possam favorecer um modelo sobre o outro. A camada de análise combina métricas clássicas de precisão factual e coerência com novas medidas de consistência de raciocínio — por exemplo, avaliar se subpassos de uma resposta mantêm integridade lógica entre si — e testes de robustez frente a inputs contraditórios.No escopo multimodal, a suíte integra pares imagem-texto, vídeo curto e áudio transcrito, permitindo verificar como cada modelo alinha informações entre modalidades. Para reduzir ruído, os criadores adotaram datasets de domínio variado — jornalismo, manuais técnicos, diálogos conversacionais e cenários de atendimento ao cliente — e inseriram casos adversariais que exploram ambiguidade lexical e armadilhas de geração. A infraestrutura foi projetada para gerar logs detalhados de tokenização, probabilidades internas quando expostas pelas APIs e pontos de falha que podem ocorrer durante a composição de respostas. Além disso, a suíte oferece um módulo experimental de “orquestração híbrida”: um controlador simples que encaminha sub-tarefas para o modelo que, empiricamente, apresenta melhor desempenho naquele tipo específico de subtarefa, criando um protótipo de pipeline composable entre ChatGPT 5.2 e Gemini.
As implicações práticas desse tipo de comparação são profundas. Para equipes de produto, a possibilidade de mapear explicitamente onde cada modelo se sobressai reduz o risco de adoção baseada apenas em rankings públicos e permite arquitetar pipelines híbridos que aproveitem pontos fortes distintos. O módulo experimental que roteia sub-tarefas abre caminho para soluções empresariais que combinam latência baixa de um modelo com a capacidade de raciocínio profundo do outro, formando verdadeiros ensembles operacionais. Por outro lado, essa composição traz desafios novos: responsabilidade sobre decisões automáticas, dificuldade para auditar cadeias de decisão quando múltiplos modelos participam, e aumento do custo operacional pela necessidade de chamadas a diferentes provedores.No plano regulatório e de governança, resultados padronizados e públicos tornam mais factível a criação de métricas mínimas de segurança e explicabilidade que compradores e reguladores possam exigir. A padronização também pressiona provedores a expor informações técnicas suficientes para auditoria — por exemplo, detalhes de calibragem de confiança e limites conhecidos de comportamento — sem, contudo, forçar divulgação que possa comprometer propriedade intelectual. Pesquisadores destacam ainda um efeito colateral: a existência de benchmarks abertos acelera a detecção de modos de falha emergentes, mas também pode orientar atores maliciosos a identificar vetores exploráveis. Assim, há um equilíbrio delicado entre transparência científica e vetorização de riscos.
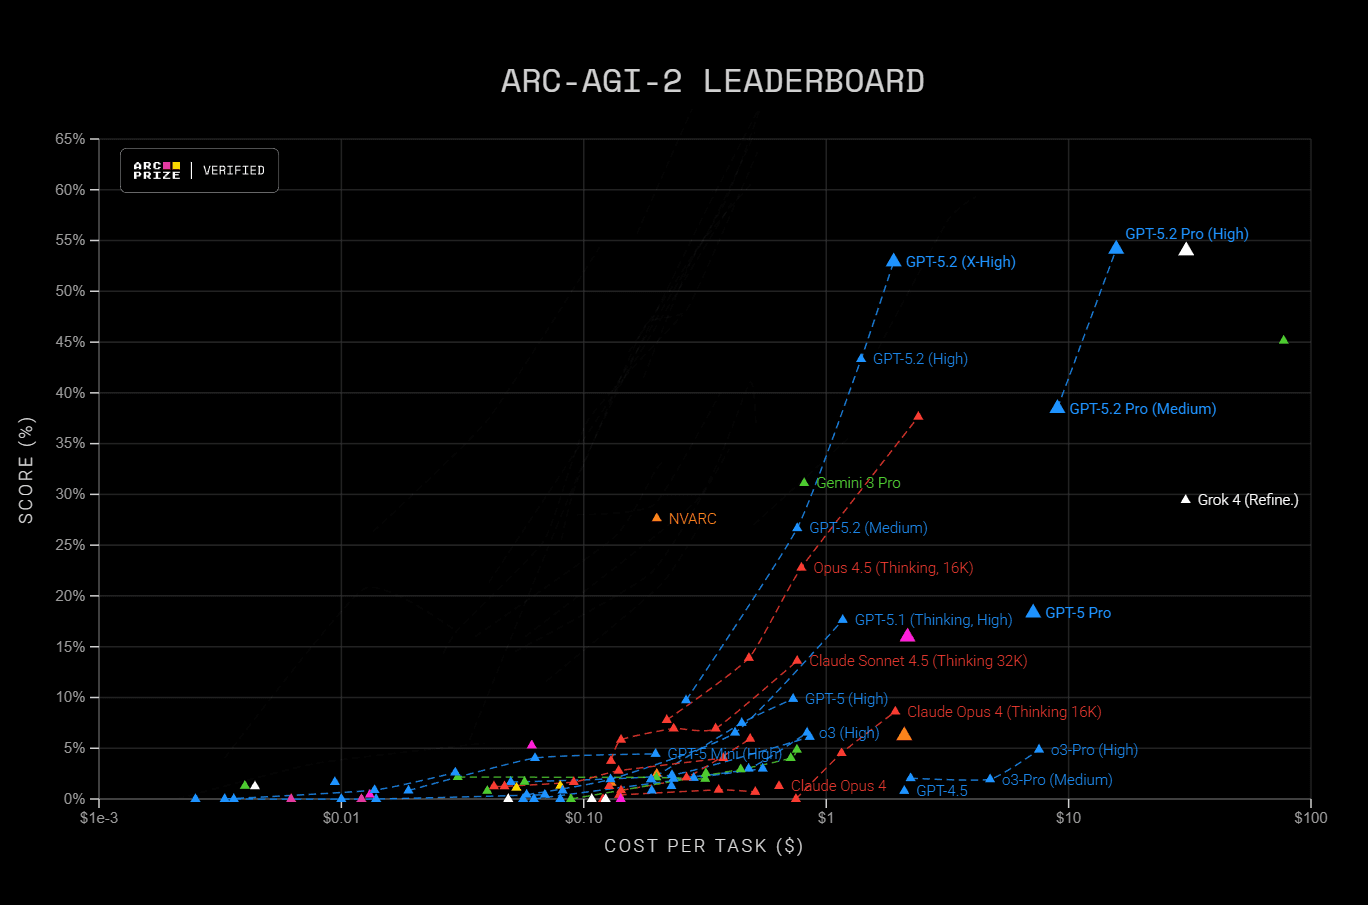
O lançamento da suíte CrossEval indica que a próxima fase da competição entre grandes modelos será menos sobre proclamadas lideranças de benchmark e mais sobre como integrar capacidades de forma responsável e mensurável. Se organizações adotarem pipelines híbridos que combinam ChatGPT 5.2 e Gemini, veremos, em curto prazo, uma série de soluções personalizadas para setores específicos — jurídico, saúde, atendimento e criação de conteúdo — com critérios de seleção fundamentados em métricas práticas. Para a comunidade técnica, o passo natural é ampliar os testes, incluir avaliações de custo-benefício em produção e desenvolver padrões de interoperabilidade que permitam reaproveitar componentes sem reconstruir integrações a cada nova versão.A médio prazo, é plausível que consórcios de empresas e laboratórios de pesquisa proponham padrões de API e formatos de relatório de desempenho, facilitando a comparação e a auditoria independente. Enquanto isso, equipes de segurança e compliance precisarão adaptar processos para auditar arquiteturas compostas. O debate em curso não é apenas sobre quem é o melhor modelo, mas sobre como extrair, combinar e governar inteligência de múltiplas origens de forma que usuários e organizações possam confiar nas decisões automatizadas.
Receba as Notícias no Seu Email
Cadastre-se gratuitamente e receba nosso resumo diário das principais notícias.
Ao cadastrar, você concorda em receber emails informativos. Você pode cancelar a qualquer momento.
Notícias Relacionadas
 Inteligência Artificial
Shanghai AI Lab publica agente de 744 bilhões de parâmetros sob licença MIT sem anúncio
Atria Dawn Preview chegou ao Hugging Face com pesos MIT, 256K de contexto e 92,5 em BrowseComp. O artigo técnico veio três dias depois dos pesos.
 Inteligência Artificial
Mythos penetrou quase todos os sistemas classificados da NSA em horas, num red-team autorizado, e os EUA tiraram o modelo do ar
Diretor da NSA disse ao Senado que o Mythos invadiu quase todos os sistemas classificados da agência em horas. A revelação muda o eixo do banimento: não é jailbreak, é a capacidade ofensiva autônoma do modelo.
 Inteligência Artificial
Google lança Gemma 4 e reforça disputa em IA aberta
Google oficializa o Gemma 4 com quatro modelos abertos sob Apache 2.0, focados em raciocínio avançado, agentes de IA e uso local do celular ao data center.